
T00ls论坛每天签到和查询域名会给tubi,有时候经常忘记,找了其他人的脚本发现查询域名有问题,简单改了一下。
tips:最近查询域名网站更新,需要改一下获取域名和代码才可以用。
钉钉接入
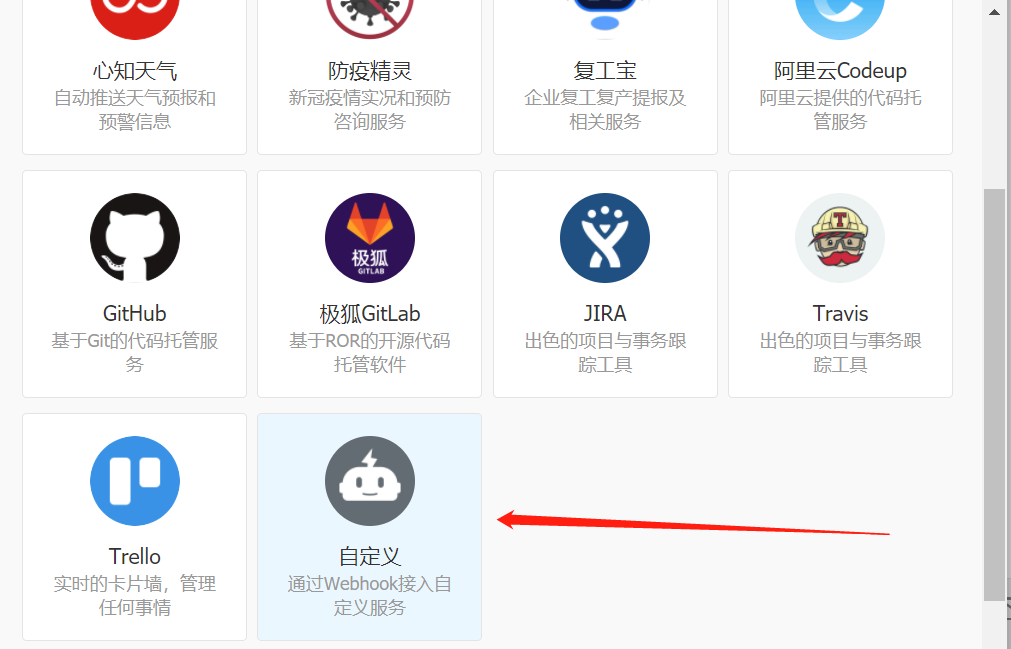
在群组添加一个自定义的机器人
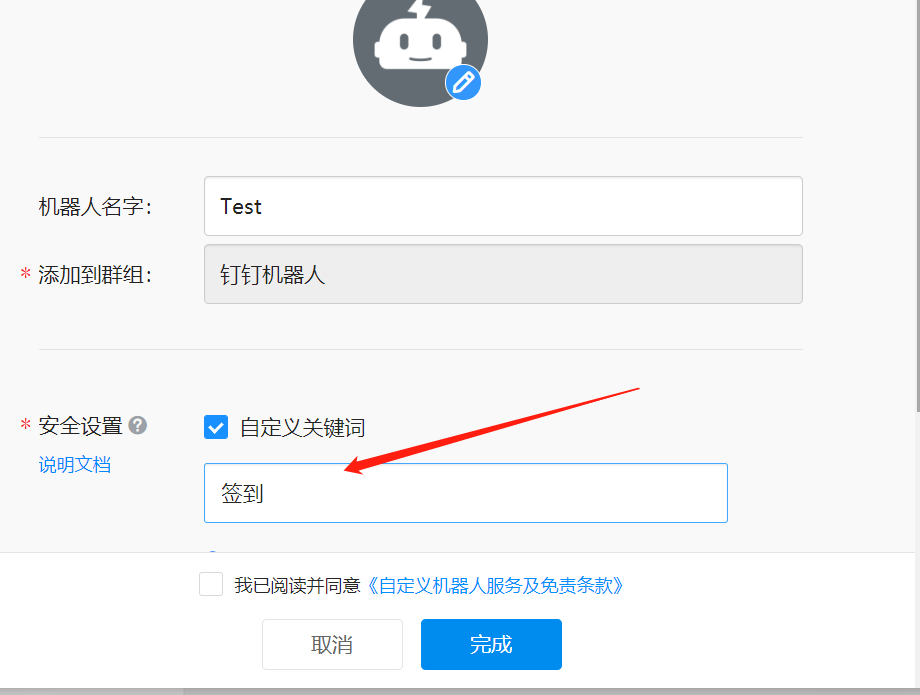
需要开启自定义关键字,调用接口发送的内容包含关键字才会发出通知
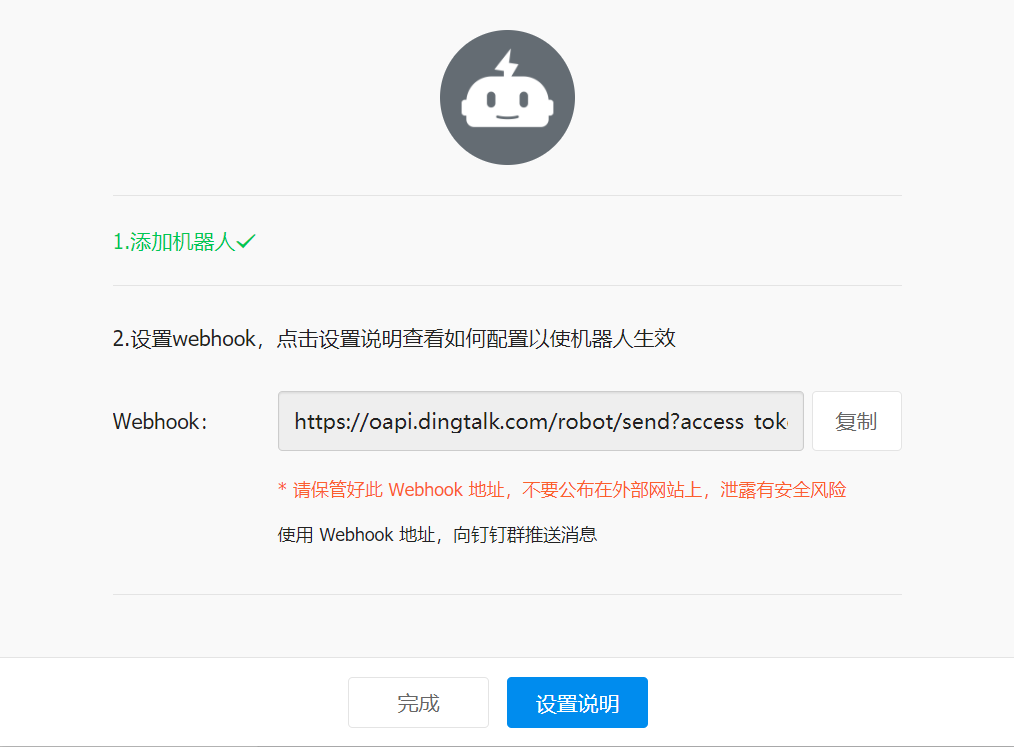
添加成功后复制Webhook
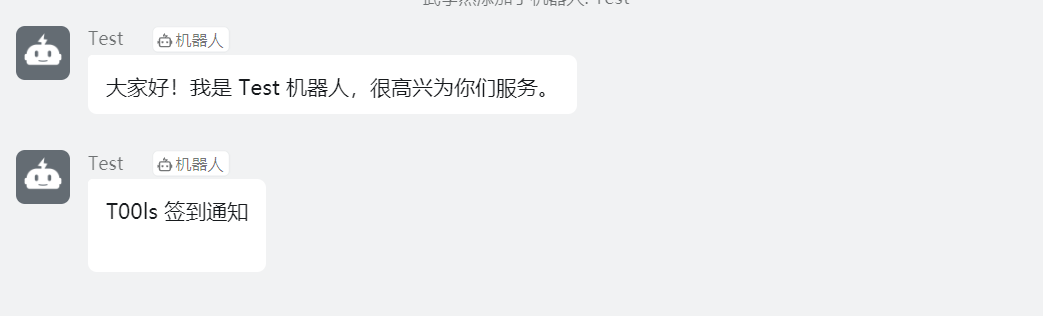
使用下方代码替换webhook_url为你的Webhook,测试机器人是否可用
import json
import requests

webhook_url = ” Your Webhook“
dd_headers = {
    "Content-Type": "application/json",
    "Charset": "UTF-8"
}
dd_message = {
    "msgtype": "text",
    "text": {
        "content": f'T00ls 签到通知\n'
    }
}
requests.post(url=webhook_url, headers=dd_headers, data=json.dumps(dd_message))
打码平台
由于采用了cf-turnstile验证方式,需要找支持turnstile的打码平台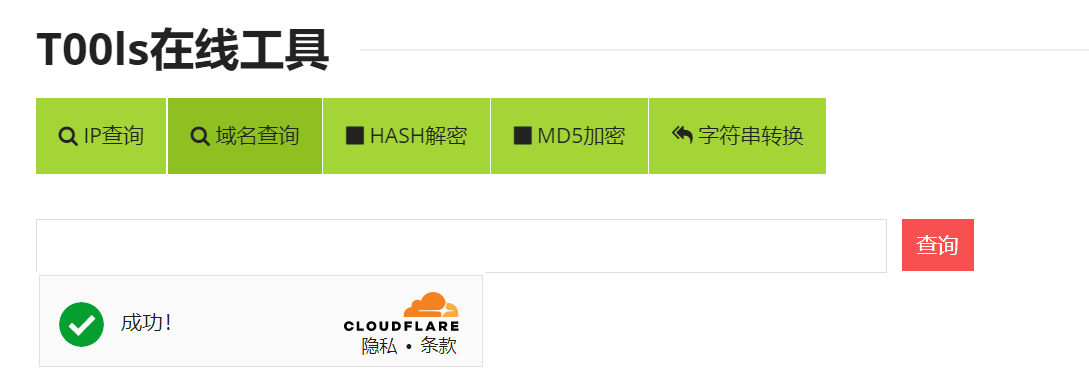
经过搜索后发现一家俄罗斯的供应商支持turnstile认证
并且它的价格很实惠,1000次只需要2.99刀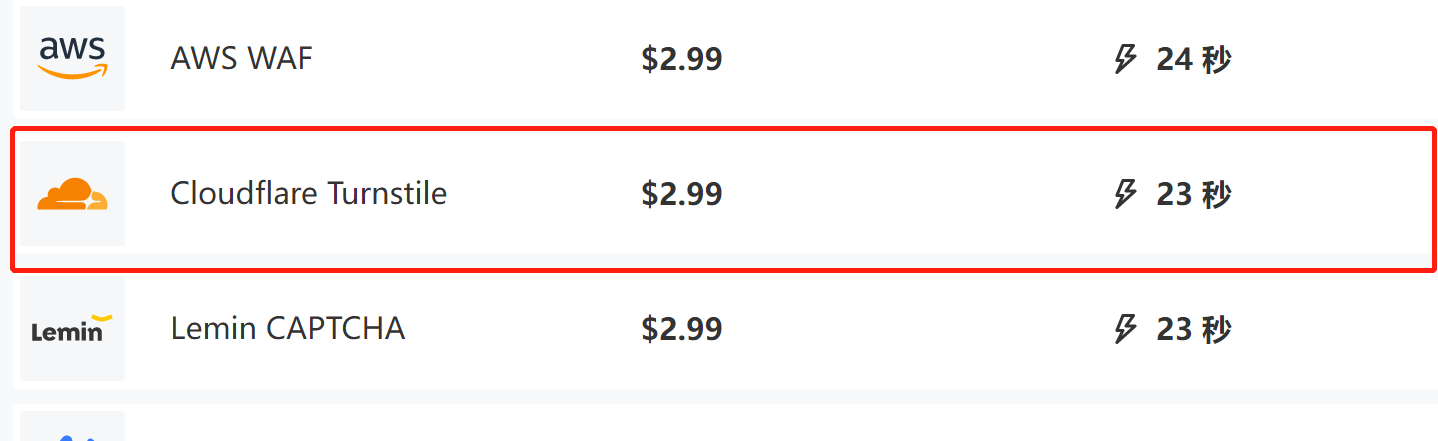
打开官网2captcha
注册账号并充值1美刀,可以使用支付宝或者加密货币进行付款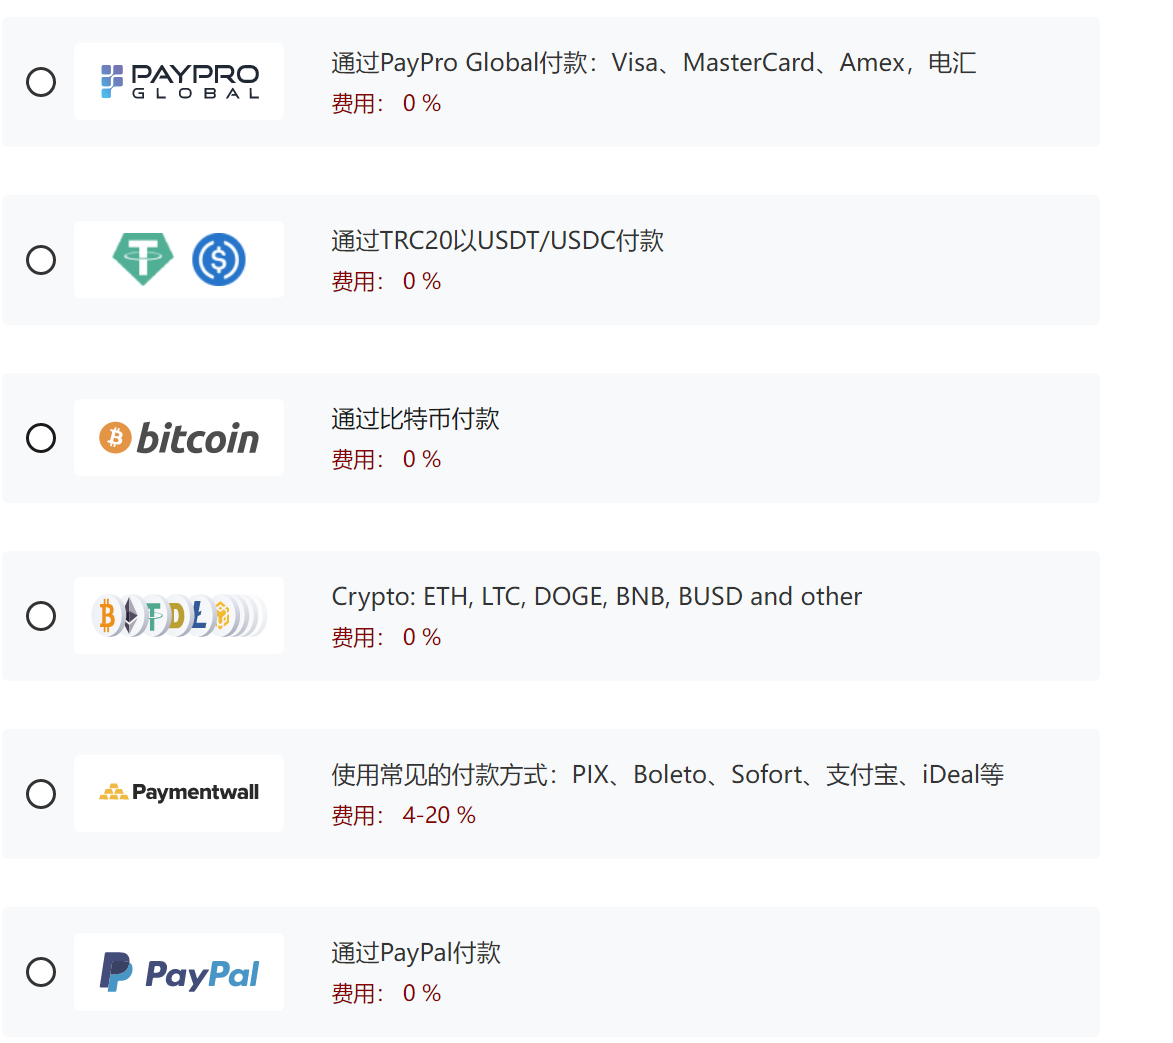
充值成功后金额会进行刷新
下面的key在调用接口时会使用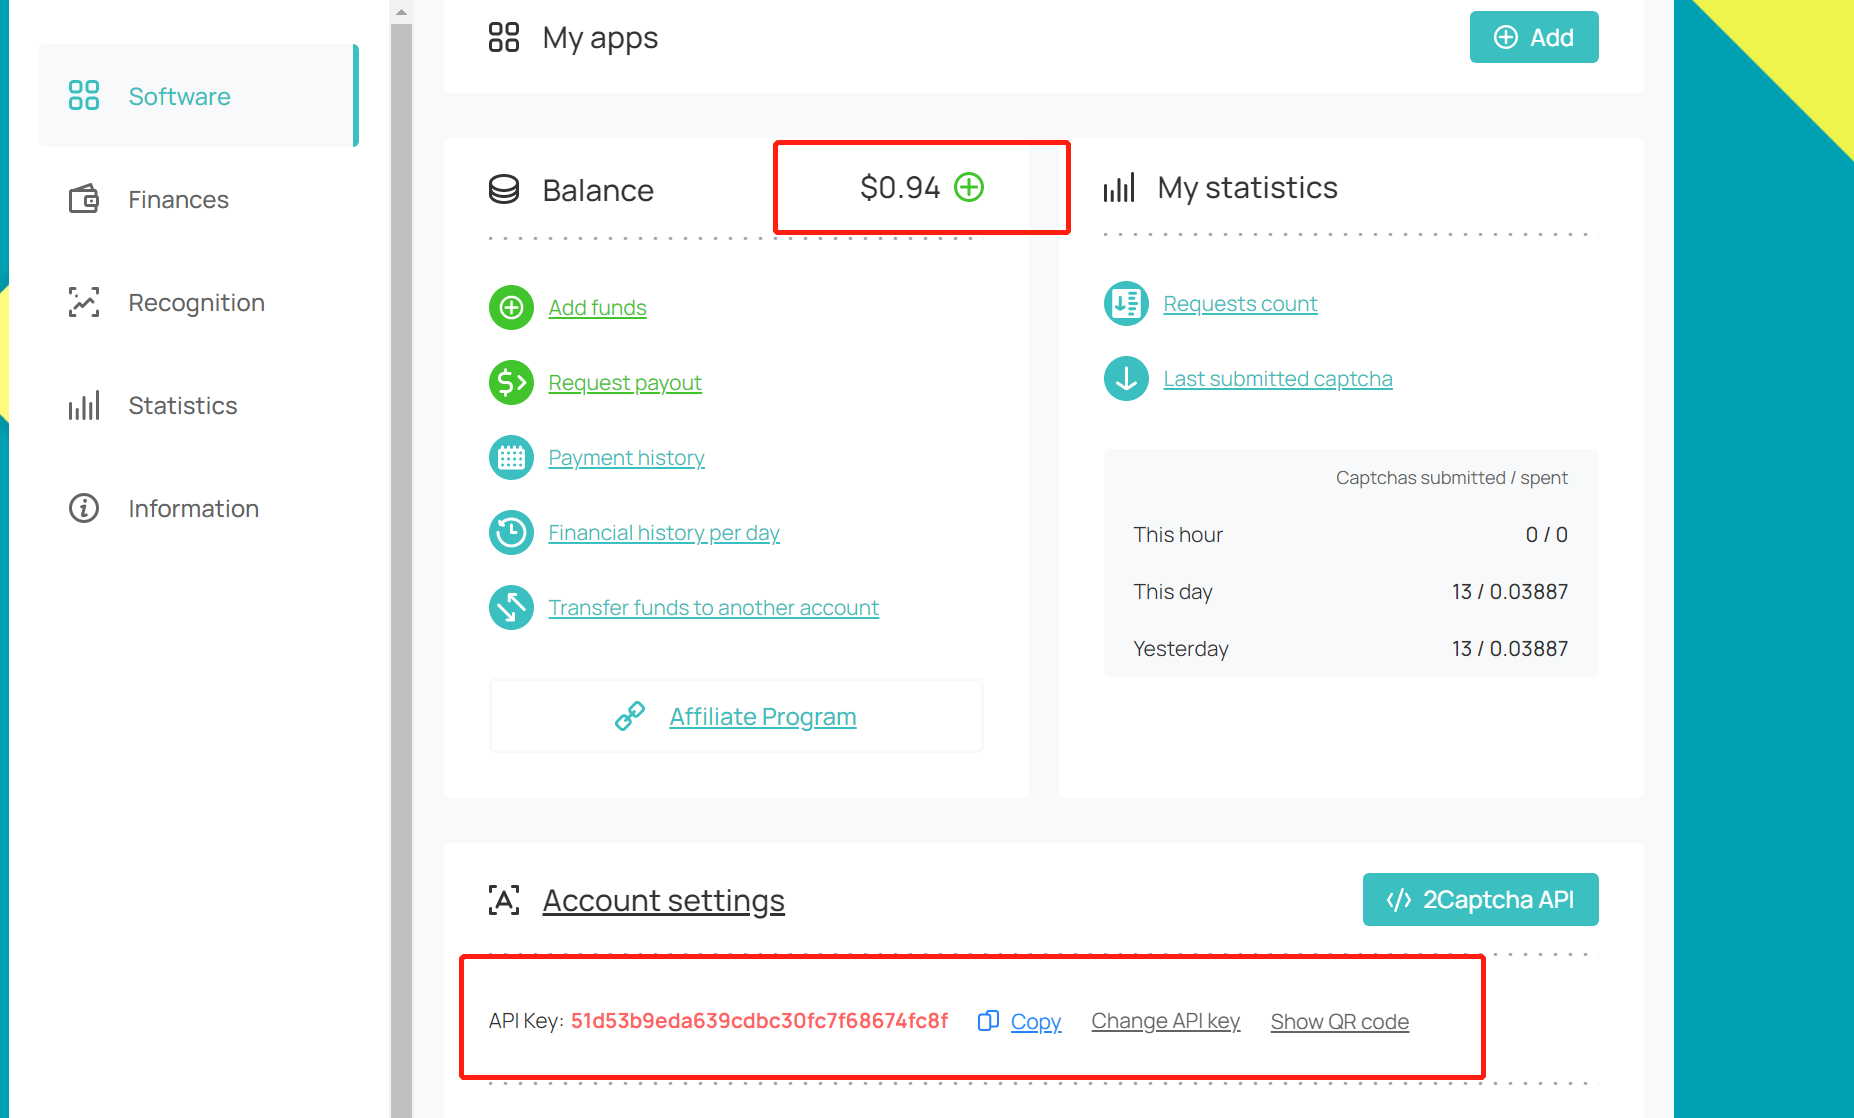
安装第三方库
pip3 install 2captcha-python
完整代码
第8行到第23行改成自己的参数配置
import json
import re
import requests
import time
import random
from twocaptcha import TwoCaptcha

username = 'Your user'  # 帐号
password = 'Your password'  # 密码MD5 32位(小写)
question_num = 1  # 安全提问 参考下面
question_answer = 'Your answer'  # 安全提问答案
key = 'Your 2captcha-key'  # 2captcha平台的key值
# 0 = 没有安全提问
# 1 = 母亲的名字
# 2 = 爷爷的名字
# 3 = 父亲出生的城市
# 4 = 您其中一位老师的名字
# 5 = 您个人计算机的型号
# 6 = 您最喜欢的餐馆名称
# 7 = 驾驶执照的最后四位数字

#钉钉通知配置信息
webhook = 'Your webhook' # 钉钉机器人的 webhook
#ua头
req_headers = {
    'User-Agent': 'Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_5) AppleWebKit/537.36 (KHTML, like Gecko) Safari/537.36',
    'Content-Type': 'application/x-www-form-urlencoded',
    'Referer': 'https://www.t00ls.com/login.html'
}
# 登录
def t00ls_login(u_name, u_pass, q_num, q_ans):
    """
    t00ls 登录函数
    :param u_name: 用户名
    :param u_pass: 密码的 md5 值 32 位小写
    :param q_num: 安全提问类型
    :param q_ans: 安全提问答案
    :return: 签到要用的 hash 和 登录后的 Cookies
    """
    login_data = {
        'action': 'login',
        'username': u_name,
        'password': u_pass,
        'questionid': q_num,
        'answer': q_ans
    }
    response_login = requests.post('https://www.t00ls.com/login.json', headers=req_headers,data=login_data)
    response_login_json = json.loads(response_login.text)

    if response_login_json['status'] != 'success':
        return None
    else:
        print('用户:', username, '登入成功!')
        formhash = response_login_json['formhash']
        t00ls_cookies = response_login.cookies
        return formhash, t00ls_cookies

# 签到
def t00ls_sign(t00ls_hash, t00ls_cookies):
    """
    t00ls 签到函数
    :param t00ls_hash: 签到要用的 hash
    :param t00ls_cookies: 登录后的 Cookies
    :return: 签到后的 JSON 数据
    """
    sign_data = {
        'formhash': t00ls_hash,
        'signsubmit': "true"
    }
    response_sign = requests.post('https://www.t00ls.com/ajax-sign.json', headers=req_headers,data=sign_data, cookies=t00ls_cookies)
    return json.loads(response_sign.text)

def domains():
    # 使用站长之家查询今天注册的域名
    start_time = time.time()
    china_url = 'https://whois.chinaz.com/suffixapi/list'
    search_data = {"module": "suffix",
                   "keyword": "{\"suffix\":\".com\",\"z_suffix\":\"\",\"c_suffix\":\"com,cn\",\"time\":\"1\",\"startDay\":\"\",\"endDay\":\"\",\"st\":\"\",\"cn\":\"\",\"city\":\"\",\"page\":1}",
                   "params": {"suffix": ".com", "z_suffix": "", "c_suffix": "com,cn", "time": "1", "startDay": "",
                              "endDay": "", "st": "", "cn": "", "city": "", "page": 1},
                   "ts": 1676629730046,
                   "token": "14ef910cd0e7943bdcdfd93a14548bf5"}
    req_search_headers = {
        'Cookie': 'toolbox_urls=translate.google.cn|google.cn|gyyg.xayjx.top|cdn.xczx.tk; pinghost=cdn1.xczx.tk; cz_statistics_visitor=06b65b23-2478-e8a5-d7f7-e889cd6a297f; Hm_lvt_aecc9715b0f5d5f7f34fba48a3c511d6=1675238221; __bid_n=1860bfaa66f767cbb44207; FPTOKEN=UYyqEvBrG/lnqxbi8JTtoCW6i3fY/P8iEe5eZChEBHuKGaey579lPzlCGBQzsc3SOi5j46Co8XrT08pwf1Q9l9ijPCjZlXI+wv3GWt00ZwjB88e5hP9XSlO6IwFSAUYvKhUiLbRxcG8SnHzmByopIdPZ19qAb6NRVp/4QpW80KElC9YB3HoIUHXfFN+z9uHMzD1jlmVpkRkfHT/sAQBiJbR3V0TldzYpRJOb3dhLkUl0nUU0WGGQikIQEyGFAeqkH3evbcFEc/CColg9vfn3BgkhMDxzAQF20fnEeKn67pad49+AyMgBKibS/KrMWsKqloHj+BOO+4PYS5iKW5Y7XPUiqeysjvCjOQtYKtgnOBMF5iZKa+B2NoJ4+T4uDblOK3UI0qFfeUfmb+rYivDydQ==|o4ADl9YRsdedqb2bh/T3hMU708yijZ5ied4VCErbS0c=|10|ed7dd2baf354d929a7c16a06c8dabb3f; qHistory=Ly93aG9pcy5jaGluYXouY29tL3N1ZmZpeGFwaS9saXN0X1dIT0lT5p+l6K+ifGh0dHA6Ly90cmVuZHMuY2hpbmF6LmNvbS9yYW5rL3RyZW5kLmFzcHhf5pWw5o2u5YaF5Y+CfGh0dHA6Ly90b29sLmNoaW5hei5jb20vdG9vbHMvYmFzZTY0LmFzcHhfQmFzZTY057yW56CB6Kej56CBfGh0dHA6Ly93aG9pcy5jaGluYXouY29tL3N1ZmZpeF/mnIDmlrDms6jlhozln5/lkI3mn6Xor6I=; Hm_lvt_ca96c3507ee04e182fb6d097cb2a1a4c=1675138340,1675656242,1676620134; Hm_lpvt_ca96c3507ee04e182fb6d097cb2a1a4c=1676620246',
        'Content-Length': '376',
        'Sec-Ch-Ua': '"Chromium";v="110", "Not A(Brand";v="24", "Google Chrome";v="110"',
        'Accept': 'application/json, text/javascript, */*; q=0.01',
        'Content-Type': 'application/json'
    }

    response_domains = requests.post(url=china_url, headers=req_search_headers, data=json.dumps(search_data),
                                     verify=False, timeout=15)
    domains = []
    txt = response_domains.text
    follower_result1 = re.findall('"domain":"(.*?)","', txt)
    for i in follower_result1:
        if '.' in i and '*' not in i:
            domains.append(i)

    end_time = time.time()
    print(f'站长之家随机找域名耗时: {end_time - start_time:.0f}秒')
    content = ''
    content += f'\n站长之家随机找域名耗时: {end_time - start_time:.0f}秒\n\n'
    return content,domains

def t00ls_domain(t00ls_hash, t00ls_cookies,content,domains):
    """
    t00ls 域名查询函数
    :param t00ls_hash: 签到要用的 hash
    :param t00ls_cookies: 登录后的 Cookies
    :return: 查询相关的日志信息
    """

    #查询域名
    start_time = time.time()
    query_url = 'https://www.t00ls.com/domain.html'
    query_status = False
    query_count = 1  # 查询重试次数
    turnstile = 1
    # 如果 t00ls 查询没有成功的话 就一直查询
    while not query_status and query_count < 4 and turnstile < 16:
        domain = random.sample(domains, 1)[0]  # 随机抽取一个 幸运儿
        try:
            turnstile += 1
            solver = TwoCaptcha(key)
            result = solver.turnstile(sitekey='0x4AAAAAAADUcE7ghOzWNmEe',url='https://www.t00ls.com/domain.html')
            if result['code']:
                ocr = result["code"]
                content += '验证码验证成功\n'
                print('验证码验证成功:'+ocr)
            else:
                # content += '验证码验证失败\n\n'
                print('验证码验证失败' )
                # content += f'继续第 {turnstile} 次验证\n'
                print(f'继续第 {turnstile} 次验证\n')
                continue
        except Exception:
            print('验证码验证出现错误了')
            print(f'继续第 {turnstile} 次验证\n')
            # content += '验证码验证出现错误了 \n\n'
            # content += f'继续第 {turnstile} 次验证\n'
            if turnstile>=16:
                content += '验证码验证失败了\n\n'
            continue

        try:
            #查询
            turnstile = 1
            print("开始查询")
            # proxyies = {'http': 'http://127.0.0.1:8080'}

            query_data = f'domain={domain}&formhash={t00ls_hash}&querydomainsubmit=%E6%9F%A5%E8%AF%A2&cf-turnstile-response={ocr}'
            response_query = requests.post(url=query_url, headers=req_headers, data=query_data, cookies=t00ls_cookies)
        except Exception:
            query_count += 1
            content += f'域名查询报错:{domain}\n\n'
            print(f'域名查询错误:{domain}\n')
            response_tb = requests.get('https://www.t00ls.com/members-tubilog.json', headers=req_headers,
                                       cookies=t00ls_cookies, timeout=15)
            if domain in response_tb.text:
                print('查询域名成功 TuBi + 1')
                content += '查询域名成功 TuBi + 1\n\n'
                # query_status = True
                break

            if query_count == 4:
                print('重试查询次数已达上限 终止查询')
                content += '重试查询次数已达上限 终止查询\n\n'
                break
            else:
                print(f'随机延时 500- 1000秒,继续第 {query_count} 次查询')
                content += f'随机延时 500-1000 秒,继续第 {query_count} 次查询\n'
                time.sleep(random.randint(500, 1000))
                continue

        if domain in response_query.text:
            response_tb = requests.get('https://www.t00ls.com/members-tubilog.json', headers=req_headers,cookies=t00ls_cookies,timeout=15)
            if domain in response_tb.text:
                print('查询域名成功 TuBi + 1')
                content += '查询域名成功 TuBi + 1\n\n'
                # query_status = True
                break
            else:
                print(f'糟糕 域名查询成功 但是 TuBi 没有增加 域名是: {domain}')
                content += f'糟糕 域名查询成功 但是 TuBi 没有增加 域名是: {domain}\n\n'
                query_count += 1
                print(f'随机延时 500-1000 秒,继续第 {query_count} 次查询')
                content += f'随机延时 500-1000 秒,继续第 {query_count} 次查询\n'
                time.sleep(random.randint(500, 1000))
        else:
            print(f'查询失败?失败的域名是: {domain}')
            content += f'查询失败?失败的域名是: {domain}\n\n'
            query_count += 1
            print(f'随机延时 500-1000 秒,继续第 {query_count} 次查询')
            content += f'随机延时 500-1000 秒,继续第 {query_count} 次查询\n'
            time.sleep(random.randint(500, 1000))
        if query_count == 4:
            print('重试查询次数已达上限 终止查询')
            content += '重试查询次数已达上限 终止查询\n\n'

    end_time = time.time()
    print(f't00ls 域名查询耗时: {end_time - start_time:.0f}秒')
    content += f't00ls 域名查询耗时: {end_time - start_time:.0f}秒\n'
    return content

def main():
    response_login = t00ls_login(username, password, question_num, question_answer)
    if response_login:
        response_sign = t00ls_sign(response_login[0], response_login[1])
        if response_sign['status'] == 'success':
            print('签到成功')
            content = '签到成功\n'
            domain_list_log = domains()
            verbose_log = t00ls_domain(response_login[0], response_login[1],domain_list_log[0],domain_list_log[1])
            content += verbose_log
        elif response_sign['message'] == 'alreadysign':
            print('今日已签到')
            content = '今日已签到\n'
            domain_list_log = domains()
            verbose_log = t00ls_domain(response_login[0], response_login[1],domain_list_log[0],domain_list_log[1])
            content += verbose_log
        else:
            print('出现玄学问题了 签到失败')
            content = '出现玄学问题了 签到失败'
    else:
        print('登入失败 请检查输入资料是否正确')
        content = '登入失败 请检查输入资料是否正确'

    """
    钉钉通知函数
    :param content: 要通知的内容
    :return: none
    """
    webhook_url = webhook
    dd_headers = {
        "Content-Type": "application/json",
        "Charset": "UTF-8"
    }
    dd_message = {
        "msgtype": "text",
        "text": {
            "content": f'T00ls 签到通知\n\n{content}'
        }
    }

    requests.post(url=webhook_url, headers=dd_headers, data=json.dumps(dd_message))

if __name__ == '__main__':
    main()
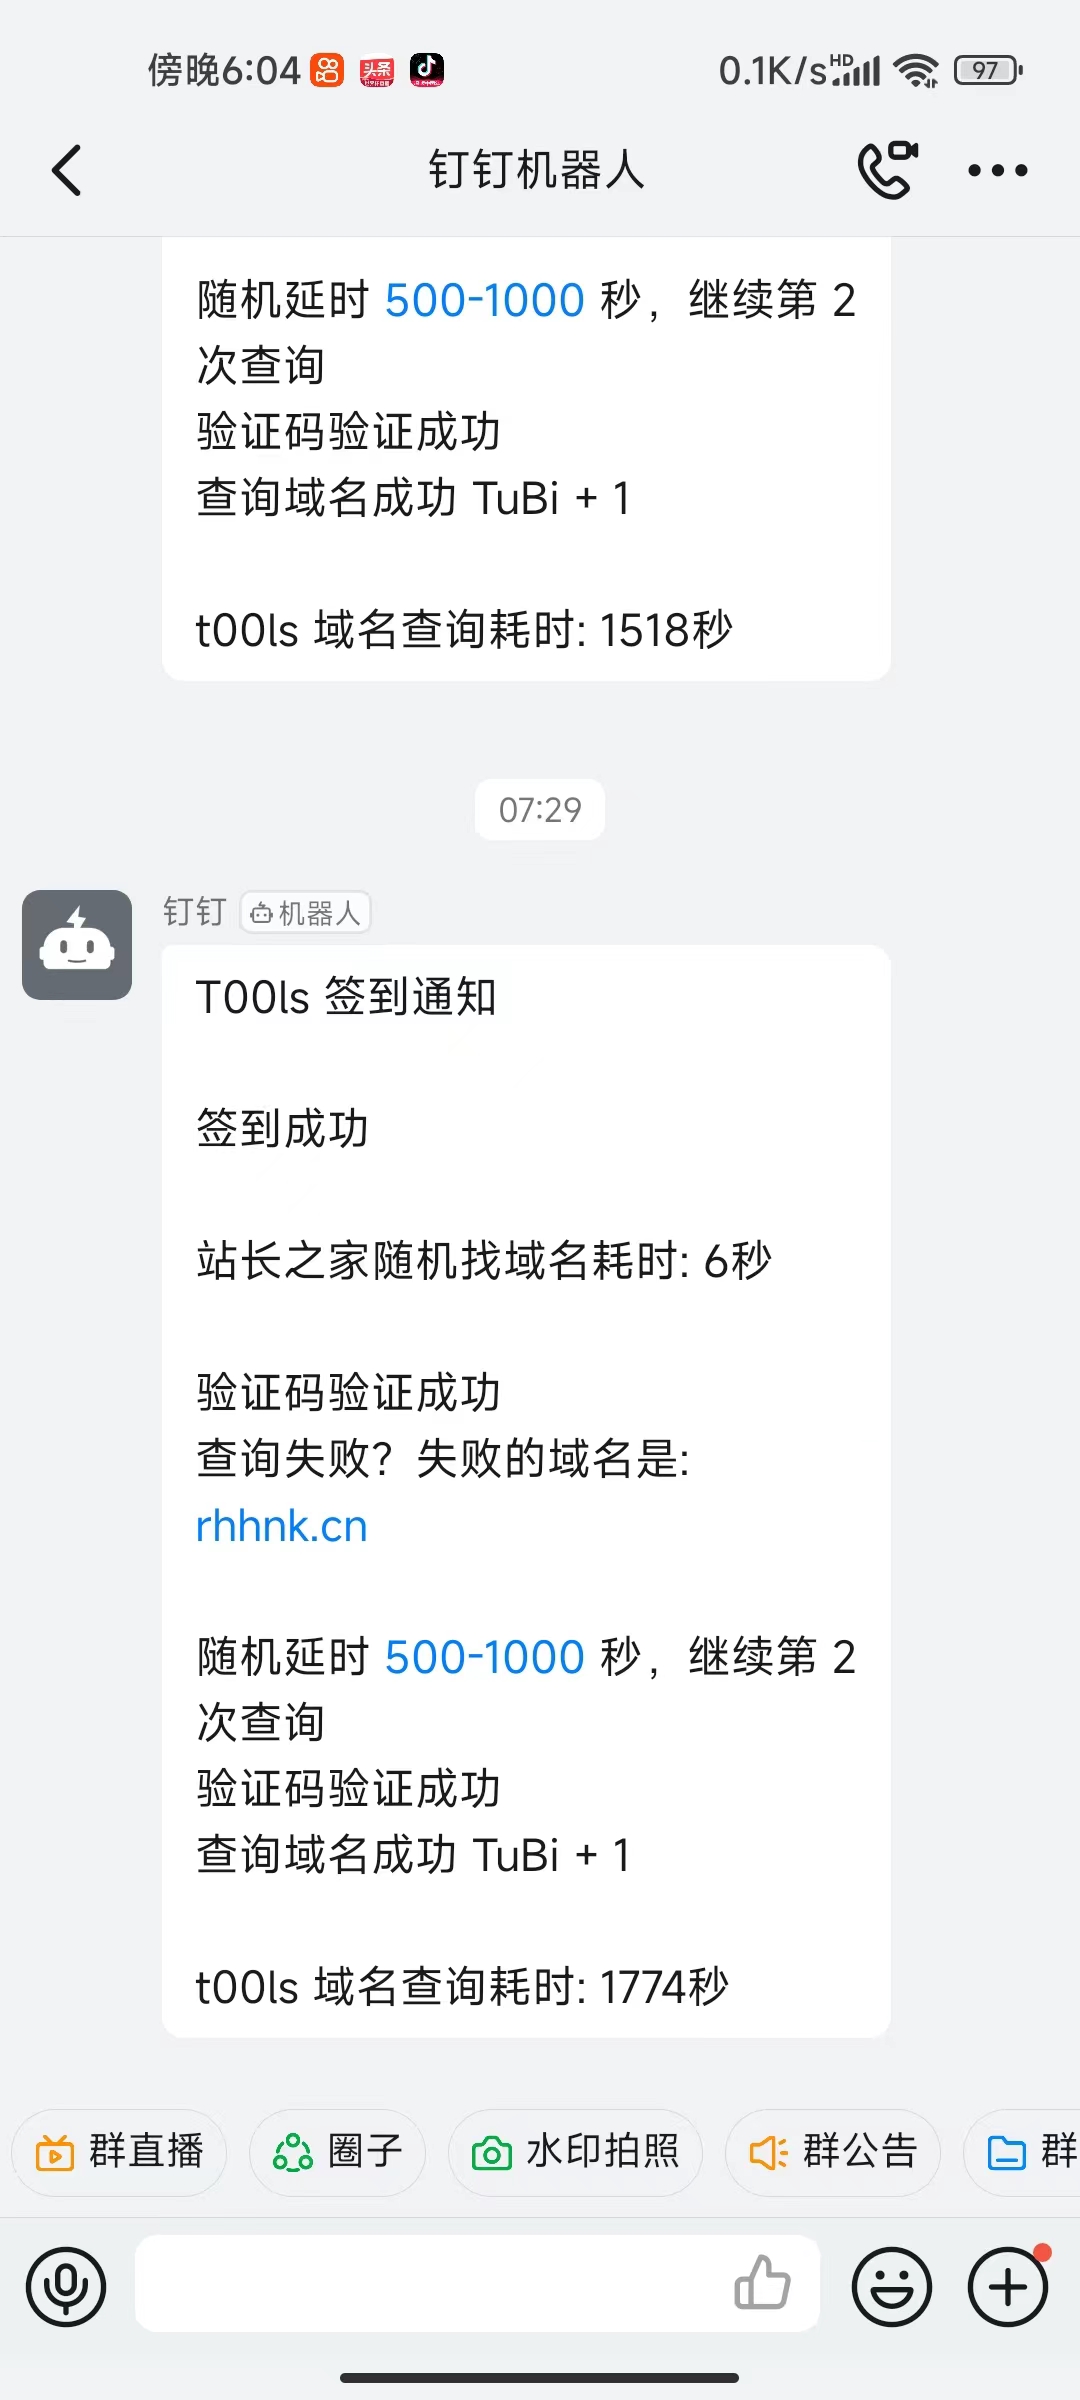
成果展示
脚本挂到服务器创建定时任务,每天会自动进行签到和域名查询
参考来源
以上文章以及代码在基于国光师傅文章进行修改
点击查看原文